Como funciona o Google?
Artigo revisto em setembro de 2026, com dados e exemplos atualizados.
No mundo dos motores de busca, o Google continua na confortável posição de líder indiscutível. Em agosto de 2026, a invenção de Larry Page e Sergey Brin apresentava uma quota de mercado de 91,1% (o Bing, o seu “maior” rival, regista 4,5%).
Em Portugal, o valor é de 88,9%, ligeiramente abaixo da média mundial, com o Bing a chegar aos 8,4%. A explicação mais provável para esta diferença não é o Bing ser melhor por cá: é o Edge vir por definição no Windows.
Ainda assim, falar de motores de busca em Portugal continua a ser basicamente sinónimo de falar do Google.
Se queremos mais visitas ao nosso site, garantir uma boa posição no Google será um ótimo ponto de partida. Mas, para tal, temos primeiro de perceber como é que este motor de busca funciona, certo?
Felizmente, o seu funcionamento não é um segredo de estado. A própria empresa explica as 3 fases aqui, mas neste artigo darei mais detalhes sobre cada uma delas.
Vamos a isto!
Fase 1: Crawling (ou Rastreio)
Porquê uma aranha na imagem? Porque o Google, como qualquer outro motor de busca, tem uma spider.
Esta spider (no caso do Google, chamada Googlebot) é um programa que tem uma função muito importante: descobrir novas páginas, e verificar se existem atualizações nas páginas já encontradas. Será ainda responsável por verificar se não surgiram links mortos, ou seja, links que já não vão dar a lado nenhum.
Este processo varia consoante o site em questão - o Google tem um algoritmo que determina a frequência com que vai realizar este trabalho, porque um site que publica dezenas de notícias por dia merece mais atenção do que um blog que só publica um par de artigos por ano.
O Google é muito curioso - sempre que colocares um novo link na tua página, ele adicionará essa página à sua lista de tarefas, para efetuar o crawling assim que possível.
Os mapas do site (sitemaps) continuam a ser uma boa prática, sobretudo em sites grandes ou com páginas mal ligadas entre si. Em sites pequenos e bem estruturados, o Google encontra quase tudo de forma autónoma.
O robots.txt não faz o que muita gente pensa
Poderás querer impedir que o Google rastreie o teu site - ou, pelo menos, parte dele. Se for esse o caso, deves familiarizar-te com o robots.txt, um ficheiro que pede a estas spiders que não investiguem determinada página, pasta ou domínio.
E é aqui que se instala o erro mais comum de todos:
O robots.txt controla o rastreio, não a indexação.
Bloquear um URL no robots.txt diz ao Googlebot “não descarregues isto”. Não diz “não mostres isto nos resultados”. Se outro site apontar um link para essa página, o Google sabe que ela existe e pode listá-la na pesquisa à mesma — sem descrição, porque nunca lhe leu o conteúdo. A própria documentação da Google é explícita: o robots.txt não é um mecanismo para manter uma página fora do Google.
Para retirar mesmo uma página dos resultados, usa-se o noindex:
<meta name="robots" content="noindex">E há uma armadilha que apanha toda a gente: se puseres o noindex na página e bloqueares o URL no robots.txt, o Googlebot nunca descarrega o HTML, portanto nunca lê a instrução. A página fica indexada precisamente por causa da tentativa de a esconder. Para o noindex funcionar, a página tem de continuar rastreável.
Em ficheiros que não são HTML (PDFs, imagens, vídeos) não existe <head> onde meter a meta tag — nesses casos usa-se o cabeçalho HTTP X-Robots-Tag: noindex.
Em resumo:
| Queres que… | Usa |
|---|---|
| os bots não gastem tempo a rastrear | robots.txt |
| a página não apareça nos resultados | noindex (e deixa rastrear) |
| ninguém consiga aceder à página | autenticação |
Mais duas notas sobre o robots.txt: as spiders podem ignorar o teu pedido (especialmente as de cariz malicioso), e o ficheiro é público. Listar /admin/ lá dentro não esconde nada — publica o mapa daquilo que querias esconder.
Plataformas como o WordPress facilitam este processo - neste CMS, quando estás a criar uma nova instalação, podes colocar um visto em “Discourage search engines from indexing this site” ou ir mais tarde a Settings > Reading para ativar essa opção.
A conclusão até aqui? Se queres garantir uma boa posição no Google, primeiro tens que confirmar que o Google consegue chegar ao teu site (e a todas as suas páginas).
Podes confirmar se o crawling no teu site foi efetuado com sucesso visitando a Search Console, uma ferramenta grátis da Google. Se tiveres fornecido um mapa do site, o mesmo também surgirá aqui.
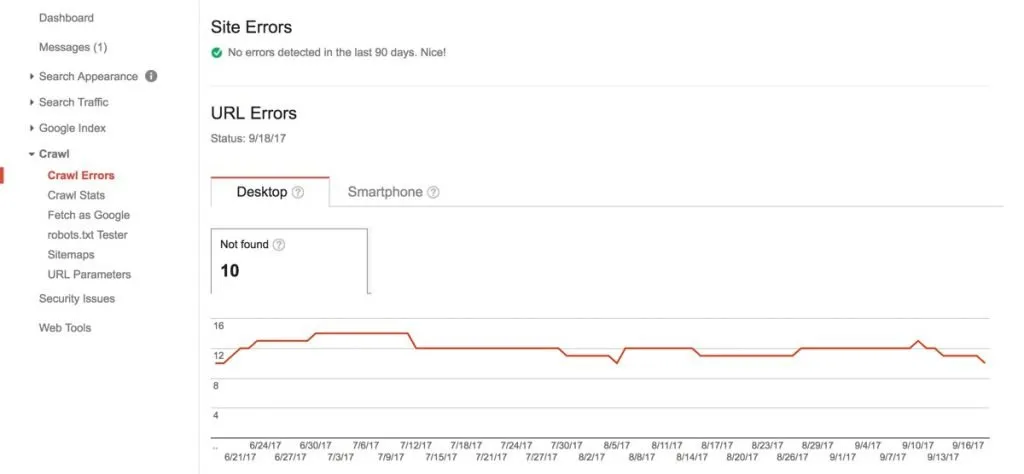
Assumindo que o Google identificou e rastreou o teu site corretamente, é tempo de atualizar o índice, que acontecerá na 2ª fase.
Fase 2: Indexing (ou Indexação)
O Googlebot vai processar cada uma das páginas que rastreou, compilando um índice com todas as palavras que encontrou (e a respetiva localização de cada uma) na página.
Aqui, todo o código HTML é investigado - title tags (o título da página), alt tags (as descrições das imagens), heading tags (os títulos e sub-títulos dos artigos) são apenas alguns exemplos.
É importante apresentar código HTML correto e válido - afinal de contas, o Google é um robô, e será através da análise do HTML que ele entenderá o conteúdo da página.
O Google executa JavaScript antes de indexar, numa segunda passagem. Isso significa que sites construídos em React, Vue ou Svelte são indexáveis — mas também que uma página que só mostra conteúdo depois de várias chamadas à API está a pedir ao Google um esforço extra que ele pode não fazer com a mesma frequência. Se o conteúdo é importante, o melhor é que venha no HTML inicial.
E há uma forma de deixar de esperar que o Google adivinhe: os dados estruturados (schema.org, escritos em JSON-LD). Em vez de confiar em que ele perceba que aquela página é uma receita, um produto ou um evento, dizes-lho explicitamente. Não é um fator de ranking — dá elegibilidade a rich results, aquelas estrelas, preços e datas que aparecem na SERP e que melhoram a taxa de cliques sem mudar a posição. Podes validar com o Rich Results Test ou com o Schema Markup Validator.
É igualmente importante pensares nas palavras-chave que achas que os teus visitantes vão utilizar, e garantir que os conteúdos as apresentam de forma natural, com variantes e sinónimos. Nunca deixes de escrever para humanos.
A conclusão aqui? Se queres que o Google entenda que o teu site é de “locais que servem bons pastéis de nata em Lisboa”, garante que o teu código HTML está otimizado para tal e que o tema está coberto com profundidade — não que a expressão aparece trinta vezes.
Fase 3: Ranking (como os resultados são apresentados)
Aqui, entramos na fase mais importante - e aquela que destaca o Google dos restantes motores de busca.
Porque é que recorremos ao Google? Porque é um motor de busca que apresenta uma enorme taxa de satisfação - raramente não nos dá o que queremos, e raramente precisamos de visitar mais do que 1 ou 2 resultados para ficarmos com a nossa questão esclarecida.
Às vezes, “até parece que adivinha” - mesmo com palavras-chave algo vagas, ele lá nos apresenta o que realmente pretendíamos. E funciona de uma forma cada vez mais personalizada: os meus resultados poderão ser diferentes de outra pessoa que pesquise pelos mesmos termos, na mesma cidade.
Tal só é possível graças ao super-complexo algoritmo do Google, que entra em ação a cada pesquisa efetuada - devolvendo-nos os resultados que entende que são os mais relevantes para nós.
E é um algoritmo que muda constantemente. A própria Google publica os números: em 2023, correu mais de 700 mil experiências que resultaram em mais de 4 mil melhorias à Pesquisa, com 4.781 lançamentos efetivos. Não é uma receita fixa que se decora uma vez.
Talvez estejas a pensar que os resultados da primeira página pagaram para lá estar - e, se disserem “patrocinado”, tratam-se de facto de investimentos em Google Ads, como este exemplo:
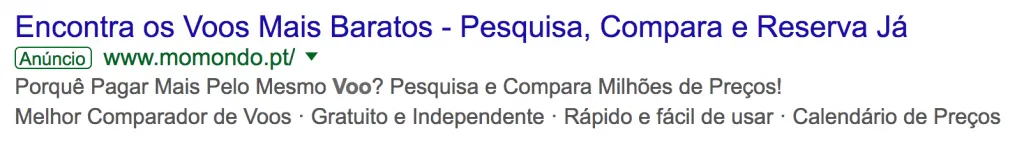
Os restantes resultados estão lá… por mérito. São os chamados resultados orgânicos - e é aqui que queres estar.
Mas como é que ele sabe o que apresentar primeiro? Como é que ele sabe que página merece mais?
Conjugando mais de 200 fatores. São de todo o tipo, cada um com um peso diferente.
Uma nota importante sobre esse número: os “200 fatores” são uma frase que a Google usou uma vez e que a indústria adotou. Não existe lista oficial. O que se sabe vem de patentes, declarações avulsas, testes da comunidade e do que a Google documenta. Serve para pensar, não para decorar.
Eis alguns exemplos, estes sim, razoavelmente consensuais:
- Presença da palavra-chave pesquisada no domínio ou no URL;
- Presença da palavra-chave pesquisada na title e heading tag;
- Cobertura do tema ao longo do conteúdo, com termos relacionados;
- Velocidade e estabilidade de carregamento da página — os Core Web Vitals: LCP (quanto tempo até aparecer o maior elemento visível), INP (quanto tempo a página demora a responder a um clique) e CLS (quanto a página “salta” enquanto carrega);
- Site com certificado SSL (HTTPS);
- Site responsive (preparado para dispositivos móveis);
- Links recebidos de outras páginas (o PageRank, já lá vamos).
Repara no que não está nesta lista, apesar de continuares a encontrá-lo em muito artigo sobre SEO: o número de partilhas e gostos nas redes sociais. A Google negou-o repetidamente — Matt Cutts em 2014 (“não incluímos o número de seguidores ou gostos no algoritmo”), John Mueller em 2015 e 2016, Gary Illyes em 2017.
Isso não quer dizer que as redes sociais sejam irrelevantes para o SEO. Quer dizer que o mecanismo é indireto: conteúdo muito partilhado é visto por mais gente, e parte dessa gente escreve sobre ele e cria links. São esses links e essas menções que contam. É um exemplo bonito de correlação que não é causalidade — e um bom lembrete de que, em Marketing Digital, convém sempre perguntar qual é o mecanismo antes de repetir uma estatística.
Sobre o mobile, há um ponto que já não admite meio-termo: desde 2024, o Google rastreia todos os sites com o crawler de telemóvel. Se o teu site não funciona bem num telemóvel, não é um problema de otimização — é o único site que o Google vê.
E o E-E-A-T?
Vais encontrar esta sigla em todo o lado: Experience, Expertise, Authoritativeness, Trustworthiness. É a experiência de primeira mão, o domínio do assunto, a autoridade reconhecida e a confiança que o site inspira.
Também aqui vale a pena ser rigoroso: o E-E-A-T não é um fator de ranking mensurável. É o critério que a Google entrega aos avaliadores humanos que testam a qualidade dos resultados — está nas Search Quality Rater Guidelines. Esses avaliadores não mexem nas posições de ninguém; o que dizem serve para a Google perceber se as mudanças que fez ao algoritmo foram boas.
Na prática, é uma descrição do que o Google gostaria de conseguir medir. Vale a pena levá-lo a sério — autoria identificada, fontes citadas, conteúdo datado — sobretudo em sites YMYL (Your Money, Your Life): saúde, finanças, direito, segurança.
O PageRank
Dos 200 fatores, dificilmente algum será mais importante que o PageRank. Se já ouviste falar em práticas de link building, é muito provavelmente devido a este fator.
O PageRank mede a importância de uma página baseado no número de links que recebe de outras páginas. Aos olhos do Google, links recebidos simbolizam votos (especialmente se forem de vários domínios diferentes), pelo que uma página recomendada por vários sites estará, em teoria, em melhor posição para surgir mais acima numa pesquisa efetuada.
Naturalmente, nem todos os links valem o mesmo - uma aparição num site de referência na indústria pesará mais do que um blog de um fã pouco influente, porque o primeiro apresenta maior autoridade (e o Google sabe-o).
Para o melhor ou para o pior, não podes conhecer a nota atribuída à tua página, pois o PageRank já não é de domínio público. No passado, quando ainda existia a Google Toolbar, podíamos consultar o PageRank de qualquer página.
Os links podem hoje declarar a sua natureza. Para além do link normal e do rel="nofollow", existe o rel="sponsored" (links pagos: publicidade, patrocínios, afiliados) e o rel="ugc" (conteúdo gerado por utilizadores: comentários, fóruns). E, desde 1 de março de 2020, estes atributos deixaram de ser ordens e passaram a ser pistas — o Google decide se as segue.
Declarar um link pago não é uma boa prática opcional: não o declarar viola as diretrizes da Google.
O Google está também cada vez melhor a combater o spam, pelo que não vale a pena comprares links ou procederes a outro tipo de táticas de carácter duvidoso - mesmo que não sejas logo “apanhado”, o mais provável é que sofras as consequências mais tarde e que o teu site seja penalizado.
Mais vale dedicares esse tempo (e dinheiro) a criar bons conteúdos e a garantir que outros sites influentes tomam conhecimento desses mesmos conteúdos.
A conclusão aqui? O Google tem um algoritmo incrivelmente complexo para apresentar os resultados mais relevantes para cada pesquisa realizada. Deves conhecer os fatores e jogar com eles, mas sem recorrer a atalhos, ou batotas (que, na gíria, se denominam práticas de black hat).
A quarta camada: as respostas geradas
Uma parte considerável das pesquisas já não termina num clique. Termina numa resposta escrita por um modelo de linguagem, no topo da própria página de resultados (as AI Overviews), num separador dedicado (o AI Mode), ou fora do Google por completo — no ChatGPT, no Claude, no Gemini, na Perplexity.
Convém perceber como é que isto encaixa nas três fases acima, porque a confusão aqui é enorme.
As AI Overviews não têm um índice próprio. Assentam no mesmo índice da Pesquisa, construído pelo mesmo Googlebot, nas mesmas três fases. O que muda é a última etapa: em vez de te devolver dez links ordenados, o Google lê os melhores resultados e escreve-te um resumo com citações.
Isso tem uma consequência prática desconfortável: não há como sair das AI Overviews sem sair também da pesquisa normal. O Google-Extended, que muita gente bloqueia a pensar que resolve o assunto, controla apenas o treino do Gemini — não tem qualquer efeito nas AI Overviews. A única forma de não aparecer nos resumos é usar nosnippet, e nesse caso perdes também os featured snippets e as descrições nos resultados normais.
Quanto ao impacto, os dados mais sólidos que conheço não vêm da indústria de SEO, vêm do Pew Research Center: numa análise a 68.879 pesquisas reais de 900 adultos, em março de 2025, cerca de 18% das pesquisas produziram um resumo de IA. Quando o resumo aparecia, os utilizadores clicavam num resultado em 8% das visitas — contra 15% quando não aparecia. E clicavam numa das fontes citadas dentro do resumo em apenas 1% dos casos.
Os outros bots
O Googlebot deixou de ser o único visitante que interessa. Hoje o teu robots.txt também é lido pelo GPTBot (OpenAI), pelo ClaudeBot (Anthropic), pelo PerplexityBot e pelo CCBot (Common Crawl), entre outros. Obedecem às mesmas regras do ficheiro que já conheces.
Decidir se os bloqueias ou não não é uma decisão técnica, é uma decisão de negócio. Bloquear protege o teu conteúdo de ser usado sem retorno. Bloquear também garante que nunca serás citado por eles. Um jornal que vive de publicidade e uma marca de software que vive de ser recomendada não têm a mesma resposta para esta pergunta — e é por isso que vale a pena fazê-la em vez de copiar o que os outros fazem.
A conclusão aqui? Nada do que está nas três fases acima ficou obsoleto. Tudo o que uma IA cita, cita-o a partir de páginas que alguém teve de rastrear, indexar e considerar relevantes. O que mudou foi o que acontece depois: a tua página pode informar a resposta sem receber a visita.
Conclusão
É importante entender como funcionam os motores de busca para conhecer as regras do jogo - só assim conseguiremos trabalhar para melhorar o posicionamento do nosso site no Google.
Nos dias que correm, temos de garantir que o nosso site agrada às pessoas, tanto ao nível do conteúdo, como noutros campos, como a usabilidade, o design e até a performance - um motor de busca sofisticado avalia todo o tipo de fatores.
E temos de aceitar uma mudança de fundo: o clique deixou de ser garantido. Quando a resposta chega sem visita, o que resta é o teu nome. As pesquisas de marca são as menos afetadas por tudo isto — quem te procura pelo nome chega na mesma, porque nenhum resumo se interpõe entre uma pessoa e a marca que ela já decidiu procurar.
Deves otimizar os teus sites para robôs, porque uma boa posição no Google continua a ser muito vantajosa se procuras mais tráfego.
No entanto, não te esqueças de colocar sempre as pessoas primeiro - lê o que eu penso sobre o hacking no Marketing - porque a ideia é garantir que os robôs reconhecem o bom trabalho que andamos a fazer para as pessoas, e não correr atrás deles!
Queres saber mais? Então este meu Guia de SEO é para ti!